- Mis à jour le
- 21 min de lecture
Backend For Frontend (BFF) : un backend par client API
Le pattern Backend For Frontend (BFF) donne à chaque client de votre API son propre backend : différence avec l'API Gateway et GraphQL, sécurité, pièges.
Le pattern Backend For Frontend donne à chaque client de votre API (application mobile, SPA web, partenaire) son propre backend, taillé pour ses écrans. Et pour le bien de votre rédacteur, vous m'autoriserez à appeler les « Backend For Frontend » BFF 😄
La plupart des architectures qu'on croise exposent une seule API générique à tous leurs clients (mobile, web, partenaires externes) et appellent ça « faire du REST proprement ». C'est pratique à maintenir, mais aucun client n'est vraiment bien servi. C'est exactement le problème que le pattern BFF (Backend For Frontend) vient corriger.
Une API générique qui ne sert bien personne
Une application mobile et une SPA web n'ont rien à voir. La première a une connexion instable, un écran minuscule, une batterie à ménager. La seconde tourne sur un poste fixe avec du réseau fibré et peut se permettre des payloads bavards. Pourtant, dans une architecture « API générique unique », on sert exactement la même réponse aux deux.
Résultat classique : le endpoint /products/{id} renvoie 40 champs. Le mobile n'en affiche que 6, mais télécharge les 40 quand même. Le front web, lui, doit faire trois appels supplémentaires (/products/{id}/reviews, /products/{id}/related, /products/{id}/stock) pour composer sa page produit, parce que l'API « générique » refuse de savoir à quoi ressemble un écran.
On appelle ça du couplage caché. L'API pense servir tout le monde équitablement ; en réalité, elle ne sert bien personne.
Ce qu'est réellement un BFF
Un BFF, c'est une couche backend dédiée à un client précis (mobile iOS, mobile Android, web, TV connectée...), placée entre ce client et les microservices métier. Son rôle n'est pas de contenir de la logique métier, c'est le boulot des services en aval, mais d'orchestrer, agréger et façonner la réponse exactement selon les besoins de ce client-là.
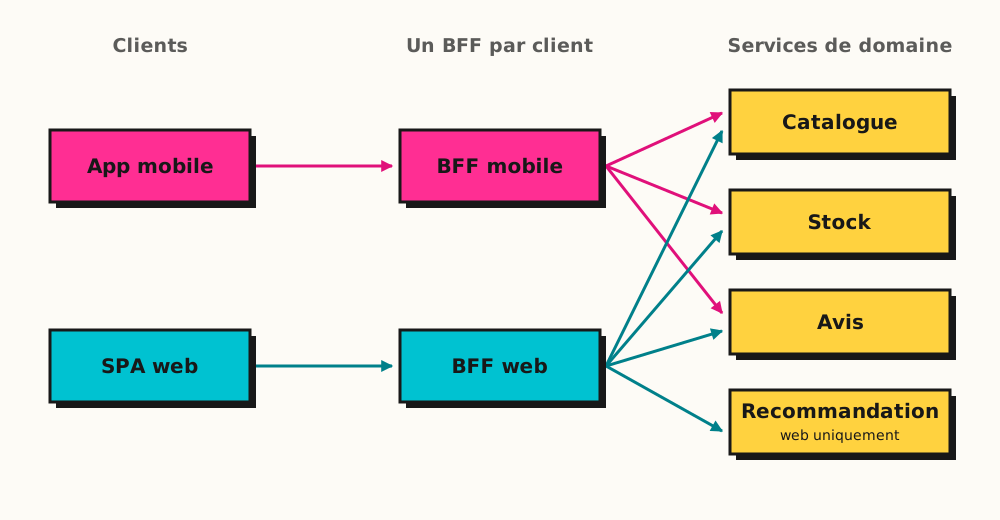
Un BFF par client : les mêmes services de domaine en aval, une réponse recomposée pour chaque client.
Chaque BFF appelle les mêmes services de domaine en aval, mais recompose la réponse différemment. Le BFF mobile renvoie une fiche produit allégée en un seul appel. Le BFF web peut se permettre d'agréger plus de données en un seul aller-retour, parce que le client web a besoin de tout afficher d'un coup et que la latence côté navigateur importe moins qu'en 4 ou 5G !
C'est ça, le principe fondateur : une équipe front possède son BFF. Ce n'est pas une couche partagée gérée par l'équipe backend « pour tout le monde ». C'est un backend qui appartient à ceux qui construisent l'expérience client, et qui évolue à leur rythme.
Le pattern n'est pas neuf : il est né chez SoundCloud et REA, et Sam Newman l'a formalisé dès 2015 dans un article de référence qui résume la règle d'or en une formule, « one experience, one BFF » : une expérience utilisateur, un BFF.
BFF ou API Gateway : pourquoi pas juste un Gateway générique ?
Question légitime, et beaucoup s'arrêtent trop vite à « un API Gateway avec un peu de transformation, ça suffit ». La différence tient au rôle de chacun :
- Un API Gateway fait du routing, de l'authentification centralisée, du rate limiting, parfois de l'agrégation basique. C'est une infrastructure transversale, gérée en général par une équipe plateforme.
- Un BFF fait de l'orchestration métier orientée client. Il connaît les écrans, les parcours utilisateurs, les cas d'usage spécifiques. Il peut contenir de la logique de présentation (formatage, calculs d'affichage, agrégation contextuelle) que le Gateway n'a aucune raison de posséder.
Les deux ne sont pas concurrents, ils sont complémentaires : le Gateway est souvent placé en amont des BFF, pour la sécurité et le routing transversal. Le BFF, lui, est spécifique à un client et appartient à l'équipe produit de ce client.
Confondre les deux, c'est le meilleur moyen de finir avec un Gateway surchargé, maintenu par une équipe plateforme qui doit arbitrer entre les besoins contradictoires de trois équipes front différentes, et où chaque évolution passe par des tickets entre équipes.
BFF ou GraphQL : remplacement ou complément ?
L'objection arrive toujours à ce stade : « GraphQL règle déjà le problème, le client demande exactement les champs dont il a besoin ». C'est vrai pour une partie du problème seulement.
Ce que GraphQL remplace vraiment
GraphQL résout proprement le sur-chargement et le sous-chargement de données. Sur un même schéma, le mobile et le web écrivent chacun leur requête :
# Mobile: the bare minimum for a small screen
query MobileProduct($id: ID!) {
  product(id: $id) {
    name
    price
    thumbnailUrl
    stock { available }
  }
}

# Web: the full product page in a single round trip
query WebProduct($id: ID!) {
  product(id: $id) {
    name
    price
    description
    images { url width }
    stock { available warehouses { name quantity } }
    reviews(first: 5) { rating comment author { displayName } }
    related(first: 8) { id name price thumbnailUrl }
  }
}
Si ce qui distingue vos clients se résume à « pas les mêmes champs, pas la même profondeur », une API GraphQL unique remplace avantageusement deux BFF REST. Autre point pour GraphQL : la spécification prévoit nativement les réponses partielles (un champ en erreur revient à null, accompagné d'une entrée dans errors), ce qui donne un cadre standard à la dégradation dont je parle plus bas.
Ce que GraphQL ne remplace pas
- L'ownership. Un schéma GraphQL unique est, par construction, partagé. Chaque besoin d'écran finit par y ajouter un champ, un argument, un type. On retrouve l'arbitrage entre équipes du Gateway surchargé, simplement déplacé dans le schéma et sa gouvernance.
- La logique propre à un client. Formatage localisé, feature flags par version d'application, adaptation pour la version 3 de l'app mobile qui traîne encore sur des milliers de téléphones non mis à jour : GraphQL ne sait pas où mettre ça, un BFF si.
- La maîtrise des coûts de requête. Laisser un client composer librement ses requêtes, c'est aussi lui laisser la possibilité d'en écrire une qui joint cinq niveaux de relations. Il faut alors des limites de profondeur, une analyse de coût, ou des requêtes persistées (seules les opérations enregistrées au build sont acceptées). Un BFF REST n'a pas ce problème : il n'expose que ce qu'il a décidé d'exposer.
- Le cache HTTP. Les requêtes GraphQL passent le plus souvent en
POSTsur un endpoint unique, donc hors de portée des caches HTTP et des CDN, sauf à revenir à des requêtes persistées enGET.
La fédération : un seul graphe, possédé par les domaines
La fédération GraphQL (Apollo Federation en est l'implémentation la plus répandue) pousse la logique plus loin : chaque équipe de domaine publie son sous-graphe (catalogue, stock, avis), un routeur les compose en un « supergraphe » et découpe chaque requête client en appels vers les bons sous-graphes. Netflix a documenté ce passage d'une API GraphQL monolithique à une fédération dans une série d'articles qui décrit bien le problème de départ : une couche d'agrégation centrale devenue goulot d'étranglement.
Organisationnellement, c'est l'inverse du BFF : l'API de bord appartient aux équipes de domaine, et les équipes front la consomment. Ça marche remarquablement bien quand il y a beaucoup de domaines, beaucoup d'équipes et des clients aux besoins proches. Ça a aussi un prix : un routeur à exploiter, des contrôles de composition du schéma en CI, une résolution d'entités entre sous-graphes à optimiser, une observabilité distribuée. Pour une PME avec deux équipes front et cinq services, c'est généralement une infrastructure disproportionnée par rapport au besoin.
Quand les deux se combinent
Les combinaisons sont plus fréquentes que le remplacement pur :
- Le BFF qui parle GraphQL. Chaque équipe front expose son propre schéma, taillé pour son application, avec des types générés côté client. On garde l'ownership du BFF et le confort de requêtage de GraphQL.
- Le BFF de sécurité devant le supergraphe. Le navigateur ne parle qu'au BFF avec un cookie de session, le BFF appelle le routeur fédéré avec un jeton. C'est la combinaison la plus courante côté web (détails dans la section sur la sécurité).
- Le BFF qui consomme le supergraphe pour un client exigeant. Un partenaire qui veut un contrat REST figé et versionné, une TV connectée qui a besoin de réponses précalculées : un BFF dédié traduit le graphe en contrat stable.
En résumé : si vos clients diffèrent par les données, GraphQL. S'ils diffèrent par les règles d'affichage, le cycle de release ou le modèle de sécurité, BFF. Et si les deux sont vrais, les deux.
Un exemple concret de BFF : el famoso « shopping cart »
Prenons un cas parlant. Un utilisateur consulte son panier.
Côté mobile, l'écran panier doit afficher : nom du produit, prix, quantité, image miniature, total. Rien de plus : l'écran est petit, la 4G capricieuse.
Côté web, le même écran affiche en plus : les produits recommandés associés, le détail des taxes, les codes promo disponibles, l'estimation de livraison par transporteur.
Sans BFF, on a deux mauvaises options :
- Le service Panier expose tout, tout le temps, et le mobile paie la note en bande passante.
- On multiplie les query params (
?fields=minimalcontre?fields=full) et le service Panier se remplit de conditions qui dépendent des besoins de chaque client. C'est exactement le couplage qu'on voulait éviter en découpant en microservices.
Avec un BFF par client :
// BFF Mobile : orchestration minimale
async function getCart(userId) {
  const cart = await cartService.get(userId)
  return {
    items: cart.items.map((item) => ({
      name: item.name,
      price: item.price,
      qty: item.qty,
      thumbnail: item.thumbUrl,
    })),
    total: cart.total,
  }
}

// BFF Web : orchestration enrichie
async function getCart(userId) {
  // Recommendations and shipping depend on the cart content, promos don't.
  const [cart, promos] = await Promise.all([cartService.get(userId), promoService.getAvailable(userId)])
  const [recommendations, shipping] = await Promise.all([
    recommendationService.getFor(userId, cart.items),
    shippingService.estimate(cart),
  ])
  return { cart, recommendations, promos, shipping }
}
Le service Panier, lui, ne change jamais. Il reste ignorant de qui l'appelle. C'est la séparation des responsabilités visée par les microservices : les besoins d'affichage restent dans le BFF et ne remontent pas dans les services de domaine.
Le même BFF en Python avec FastAPI : parallélisme, timeouts et dégradation partielle
L'exemple ci-dessus montre la forme. En production, la question intéressante est ailleurs : que se passe-t-il quand le service Recommandation met trois secondes à répondre, ou ne répond plus du tout ? Avec Promise.all tel quel, la page panier entière attend, puis échoue. Voici le BFF web du panier en Python (FastAPI et httpx, Python 3.11 ou plus récent pour asyncio.timeout), avec une règle explicite : le panier est obligatoire, tout le reste est optionnel.
import asyncio
import logging
from collections.abc import AsyncIterator, Awaitable
from contextlib import asynccontextmanager
from dataclasses import dataclass, field
from typing import Any, TypeVar

import httpx
from fastapi import FastAPI, HTTPException, Request

logger = logging.getLogger("bff.web")
T = TypeVar("T")

CART_URL = "http://cart.internal"
PROMO_URL = "http://promo.internal"
RECO_URL = "http://reco.internal"
SHIPPING_URL = "http://shipping.internal"


@asynccontextmanager
async def lifespan(app: FastAPI) -> AsyncIterator[None]:
    # One pooled client for the whole process: no TCP/TLS handshake per downstream call.
    timeout = httpx.Timeout(2.0, connect=0.5)
    async with httpx.AsyncClient(timeout=timeout) as client:
        app.state.http = client
        yield


app = FastAPI(lifespan=lifespan)


async def get_json(http: httpx.AsyncClient, url: str) -> Any:
    response = await http.get(url)
    response.raise_for_status()
    return response.json()


async def post_json(http: httpx.AsyncClient, url: str, payload: Any) -> Any:
    response = await http.post(url, json=payload)
    response.raise_for_status()
    return response.json()


async def required(name: str, call: Awaitable[T]) -> T:
    try:
        return await call
    except httpx.HTTPError as exc:
        logger.error("required dependency %s failed: %r", name, exc)
        raise HTTPException(status_code=502, detail=f"{name} unavailable") from exc


@dataclass
class Degradation:
    """Tracks which optional parts of the response were replaced by a fallback."""

    missing: list[str] = field(default_factory=list)

    async def optional(self, name: str, call: Awaitable[T], *, budget: float, fallback: T) -> T:
        try:
            async with asyncio.timeout(budget):
                return await call
        except (TimeoutError, httpx.HTTPError) as exc:
            logger.warning("optional dependency %s degraded: %r", name, exc)
            self.missing.append(name)
            return fallback


@app.get("/web/cart")
async def web_cart(request: Request) -> dict[str, Any]:
    http: httpx.AsyncClient = request.app.state.http
    user_id = request.state.user_id  # set by the authentication middleware
    degradation = Degradation()

    # Phase 1: cart and promos are independent, fetch them in parallel.
    # If the cart fails, gather re-raises at once; the promos call stays bounded by its own budget.
    cart, promos = await asyncio.gather(
        required("cart", get_json(http, f"{CART_URL}/carts/{user_id}")),
        degradation.optional(
            "promos", get_json(http, f"{PROMO_URL}/users/{user_id}/promos"), budget=0.3, fallback=[]
        ),
    )

    # Phase 2: recommendations and shipping need the cart content.
    recommendations, shipping = await asyncio.gather(
        degradation.optional(
            "recommendations",
            post_json(http, f"{RECO_URL}/recommendations", {"user_id": user_id, "items": cart["items"]}),
            budget=0.25,
            fallback=[],
        ),
        degradation.optional(
            "shipping", post_json(http, f"{SHIPPING_URL}/estimates", cart), budget=0.4, fallback=None
        ),
    )

    return {
        "cart": cart,
        "promos": promos,
        "recommendations": recommendations,
        "shipping": shipping,
        "degraded": degradation.missing,
    }
Quelques choix méritent d'être expliqués, parce que ce sont eux qui font la différence entre un BFF qui amortit les pannes et un BFF qui les amplifie :
- Chaque dépendance a son budget de temps. Le panier dispose du timeout global du client HTTP (2 secondes), les recommandations de 250 ms. La latence maximale de l'écran se calcule donc à l'avance : la phase 1 dure au plus le temps du panier, la phase 2 au plus 400 ms. Sans budget explicite, la latence de votre page est celle de votre service le plus lent un mauvais jour.
- Le repli ne ment pas. Le fallback des frais de livraison est
None(« estimation indisponible »), jamais0: afficher une livraison gratuite parce qu'un service est tombé, c'est transformer un incident technique en litige commercial. Le choix du fallback est une décision produit, pas un détail d'implémentation. - Le client sait que la réponse est partielle. Le champ
degradedpermet au front d'afficher « recommandations indisponibles » plutôt qu'un bloc vide qu'on prendrait pour un bug, et vous donne une métrique directe : le taux de réponses dégradées par dépendance. - Un seul client HTTP partagé. Recréer un client par requête, c'est payer une poignée de main TCP et TLS à chaque appel aval, soit souvent plus que le temps de traitement du service lui-même.
Ce qui manque volontairement pour garder l'exemple lisible : un circuit breaker (arrêter d'appeler un service qui échoue en boucle au lieu d'attendre son timeout à chaque requête), la propagation d'un identifiant de trace vers les services aval, et un cache court sur les données peu volatiles comme les promotions. En Rust avec Axum, la structure est la même : tokio::join! pour le parallélisme, tokio::time::timeout pour les budgets, et le compilateur vous oblige à traiter chaque Result, ce qui rend l'oubli d'un cas d'échec nettement plus difficile.
Le BFF comme couche de sécurité pour les applications web
Il y a une deuxième raison, souvent plus décisive que la forme des payloads, de mettre un BFF devant une SPA : ne jamais laisser de jeton OAuth dans le navigateur.
Le problème des jetons côté navigateur
Une SPA qui gère OAuth elle-même finit par stocker un access token (et souvent un refresh token) quelque part en JavaScript : localStorage, sessionStorage ou mémoire. Dans tous les cas, un script malveillant qui s'exécute dans la page (XSS, dépendance npm compromise, script tiers détourné) peut lire ces jetons et les exfiltrer. L'attaquant les rejoue ensuite depuis sa propre machine, tant qu'ils sont valides, sans que l'utilisateur ait besoin d'avoir l'onglet ouvert.
Le pattern : jetons côté serveur, cookie de session côté navigateur
La RFC 10017, « OAuth 2.0 for Browser-Based Applications », publiée comme bonne pratique courante (BCP 212) par l'IETF en 2026, décrit ce pattern sous le nom de BFF (section 6.1) ; on le trouve aussi sous le nom de « token handler ». Le principe :
- Le BFF est un client OAuth confidentiel : il possède son propre secret auprès du serveur d'autorisation et mène le flux « authorization code » (avec PKCE) côté serveur.
- Les jetons obtenus restent sur le serveur, associés à la session de l'utilisateur. Le BFF gère leur renouvellement.
- Le navigateur ne reçoit qu'un cookie de session, inaccessible au JavaScript.
- La SPA appelle le BFF avec ce cookie ; le BFF ajoute le jeton d'accès et relaie l'appel vers l'API.
La RFC exige les attributs Secure et HttpOnly, recommande SameSite=Strict, Path=/, pas d'attribut Domain, et le préfixe __Host-Http-, qui garantit que le cookie a été posé par le serveur via Set-Cookie, en HTTPS, sans possibilité de l'étendre à un sous-domaine (MDN détaille les préfixes) :
Set-Cookie: __Host-Http-session=8f3c...e41a; Path=/; Secure; HttpOnly; SameSite=StrictLe préfixe __Host-Http- est récent (supporté par Chrome et Firefox depuis 2025) ; un navigateur qui ne le connaît pas le traite comme un nom de cookie ordinaire, les attributs continuent donc de s'appliquer. Côté BFF, les deux pièces essentielles tiennent en quelques lignes :
from fastapi import HTTPException, Request, Response
from fastapi.responses import JSONResponse

SESSION_COOKIE = "__Host-Http-session"
SAFE_METHODS = {"GET", "HEAD", "OPTIONS"}


@app.middleware("http")
async def require_custom_header(request: Request, call_next):
    # A custom header forces a CORS preflight: a cross-site form or image cannot send it.
    if request.method not in SAFE_METHODS and request.headers.get("x-bff-csrf") != "1":
        return JSONResponse({"detail": "missing anti-CSRF header"}, status_code=403)
    return await call_next(request)


@app.get("/api/orders")
async def list_orders(request: Request) -> Response:
    # `sessions` is a server-side store (Redis, database) mapping session ids to OAuth tokens.
    session = await sessions.load(request.cookies.get(SESSION_COOKIE))
    if session is None:
        raise HTTPException(status_code=401)
    access_token = await session.fresh_access_token()  # refreshed server-side when expired
    upstream = await request.app.state.http.get(
        f"{ORDERS_API}/orders", headers={"Authorization": f"Bearer {access_token}"}
    )
    return Response(
        upstream.content,
        status_code=upstream.status_code,
        media_type=upstream.headers.get("content-type"),
    )
Notez que le BFF expose des routes explicites (/api/orders), pas un proxy générique /api/{path} vers n'importe quelle API interne : un BFF de sécurité qui relaie tout ce qu'on lui envoie devient une porte d'entrée vers votre réseau interne.
Ce que ça apporte
- Plus de vol de jetons par XSS. Il n'y a rien à exfiltrer : le cookie est
HttpOnly, les jetons n'ont jamais quitté le serveur. - Un client OAuth confidentiel. Le serveur d'autorisation authentifie réellement l'application, ce qui est impossible avec un client public dans le navigateur, et permet des refresh tokens de longue durée sans les exposer.
- Une SPA plus simple. Plus de bibliothèque OAuth côté front, plus de gestion de renouvellement, de course entre onglets ou de jeton expiré au milieu d'un formulaire.
- Une surface d'audit concentrée. Journalisation, révocation de session et politique de sécurité se gèrent au même endroit.
La RFC est explicite : elle recommande fortement ce modèle pour les applications métier, les applications sensibles et celles qui manipulent des données personnelles. Autrement dit, la plupart des applications de gestion qu'une PME fait développer.
Ses limites
- Une XSS reste grave. Le script malveillant ne peut plus voler les jetons, mais il peut toujours appeler le BFF depuis le navigateur de la victime, avec son cookie, tant que la page est ouverte (la RFC le décrit comme un détournement du client, section 5.1.4). Le BFF réduit le rayon d'impact, il ne remplace ni la CSP, ni l'hygiène des dépendances.
- Le BFF doit être sur le même site que la SPA. Avec
SameSite=Strictet le blocage croissant des cookies tiers, SPA et BFF doivent partager le même domaine enregistrable (idéalement la même origine, derrière un reverse proxy). Une SPA sur un domaine et un BFF sur un autre ne fonctionne pas : le navigateur n'envoie pas le cookie de session. - La session redevient un état serveur. Il faut un magasin de sessions partagé entre les instances (ou des jetons chiffrés dans le cookie, ce que la RFC envisage), avec sa disponibilité, son expiration et sa révocation.
- Un maillon de plus sur le chemin critique. Chaque appel API traverse le BFF : il doit être aussi disponible et observable que les services qu'il protège.
SameSite=Stricta un effet de bord. Un utilisateur qui arrive depuis un lien externe (un e-mail, par exemple) ne transmet pas le cookie lors de cette première navigation. Les appelsfetchsuivants de la SPA, eux, l'envoient normalement, mais un rendu serveur de la première page le verra comme déconnecté.- Ça ne concerne pas le mobile natif. Une application native n'a pas de cookies de navigateur à protéger ; elle suit sa propre bonne pratique (RFC 8252, navigateur système et PKCE). Le BFF mobile, s'il existe, est là pour la forme des données, pas pour ce rôle.
Nuance importante par rapport à la section « Quand ne PAS faire de BFF » plus bas : même avec une seule application web, le BFF de sécurité peut se justifier à lui seul dès que l'application manipule des données sensibles. Si votre front est en Next.js, vous avez d'ailleurs souvent déjà cette couche serveur sous la main (route handlers, rendu serveur) : c'est un endroit naturel pour garder les jetons hors du navigateur.
Les pièges classiques du BFF
- Le BFF qui devient un god object. Une seule équipe crée « le BFF » pour tous les clients parce que « c'est plus simple à maintenir ». Cela va à l'encontre du pattern : un BFF unique qui sert le mobile et le web n'est qu'une API Gateway sous un autre nom.
- Le BFF qui contient de la logique métier. Une règle de calcul de prix, une validation de stock : ça n'a rien à faire dans un BFF. Le BFF orchestre et façonne, il ne décide pas. Le jour où deux BFF réimplémentent différemment la même règle métier, on a un bug de cohérence garanti. Même chose pour les écritures qui touchent plusieurs services : coordonner une commande, un paiement et une réservation de stock depuis le BFF, c'est lui confier une saga, avec ses compensations et ses états intermédiaires. Ce travail appartient aux services de domaine, et les transactions distribuées entre microservices ont leurs propres mécanismes (outbox, idempotence, sagas) qui n'ont rien à faire dans une couche de présentation.
- La duplication de code entre BFF. Oui, chaque BFF mobile, web ou partenaire va dupliquer une partie de la logique d'orchestration. C'est un coût assumé du pattern, pas un défaut caché. On le mitige avec des librairies partagées côté orchestration pure (clients HTTP, retry, circuit breaker), jamais avec du code métier partagé.
- Ignorer la gestion des pannes partielles. Un BFF agrège plusieurs services. Si le service Recommandation tombe, doit-on afficher un panier sans recommandations ou faire échouer toute la requête ? Sans stratégie de dégradation (timeout court et fallback), le BFF hérite de la fragilité de tous les services qu'il orchestre, multipliée.
Quand ne PAS faire de BFF
Si on n'a qu'un seul client (une seule app web, pas de mobile, pas de partenaires), un BFF n'apporte rien : c'est une couche réseau de plus à opérer. Le BFF se justifie quand les besoins des clients divergent suffisamment pour que la mutualisation coûte plus cher qu'elle ne rapporte. En dessous de ce seuil, une API bien pensée avec du GraphQL ou des query params intelligents fait très bien le travail.
C'est le même raisonnement que pour le choix entre monolithe modulaire et microservices : on découpe quand le coût de la mutualisation devient réel, pas par principe.
Avant de créer un BFF : les questions à se poser
Avant d'ajouter une couche à votre architecture, quelques questions permettent de trancher rapidement :
- Combien de clients réellement différents avez-vous ? Pas combien de plateformes, combien d'expériences distinctes. Une app iOS et une app Android au parcours identique peuvent partager un BFF ; « one experience, one BFF ».
- En quoi diffèrent-ils ? Par les champs (GraphQL suffit peut-être), par les règles d'affichage et le rythme de release (BFF), par le modèle de sécurité (BFF de sécurité pour le web).
- Qui va posséder chaque BFF ? S'il n'y a pas d'équipe front capable de le maintenir et de l'opérer, vous créez un service orphelin que l'équipe backend finira par récupérer, et le pattern aura perdu sa raison d'être.
- Quelle est votre stratégie de dégradation ? Pour chaque dépendance du BFF : obligatoire ou optionnelle, quel budget de temps, quel fallback honnête.
- Où vivent les jetons de vos utilisateurs web aujourd'hui ? S'ils sont dans le
localStoraged'une application qui manipule des données personnelles, la question du BFF de sécurité se pose indépendamment du reste.
Si plusieurs de ces questions restent sans réponse claire, c'est le signe que le sujet n'est pas le BFF mais la cartographie de vos clients, de vos équipes et de vos flux. C'est souvent par là que commence une mission de conseil en architecture, avant d'écrire la moindre ligne de code.
Ce qu'il faut retenir
Le BFF n'est pas une couche technique de plus : c'est une réponse à un problème d'ownership : qui possède la donnée que voit l'utilisateur, et qui décide comment elle est façonnée ?
Si la réponse est « l'équipe front qui construit l'écran », alors le BFF doit exister, et il doit appartenir à cette équipe. Si la réponse est « un backend générique quelque part », on n'a rien résolu : on a seulement déplacé le couplage d'un endroit à un autre.
Un sujet à creuser pour votre projet ?
Discutons de votre contexte technique et de vos enjeux.
Parlons de votre projet